文章
CS336 Assignment 3:从 IsoFLOPs 到 48 B200-hour 配置外推
逐步拆解 CS336 Assignment 3:IsoFLOPs 最优点选择、log-log 幂律拟合、loss 外推、B200 墙钟时间换算、实验结果过滤以及合法训练配置生成。
专题 Stanford CS336 学习笔记 第 3 篇 / 共 5 篇
本文对应 Stanford CS336 Assignment 3: Scaling。我不是 Stanford 在校生,也没有课程训练 API、VPN 或 Gradescope 权限。本文中的 Part 2 数字来自作业提供的合成数据;Part 3 完成的是离线分析与配置生成管线,没有真实 Stanford API experiments,因此没有声称得到 48 B200-hour leaderboard 答案。
先说明完成边界
原来的文章容易让人误以为“代码能输出一个配置”就等于“完成了 Assignment 3”。两者差得很远。下面先把已经完成和无法完成的部分分开:
| 作业部分 | 本文状态 | 使用的数据 | 能得出的结论 |
|---|---|---|---|
| Part 2:合成 IsoFLOPs 分析 | 完成 | handout 提供的 72 条合成 run | 可以复现 9 个最优点、两条 scaling law 和指定 compute 下的预测 |
| Part 2:图表与数值复现 | 完成 | 同上 | 可以生成 SVG、JSON,并回答 、 FLOPs 问题 |
| Part 3:API 数据清洗与拟合代码 | 完成 | API schema 与本地 fixture | 可以过滤 completed run、按 compute 分组、拟合并生成候选配置 |
| Part 3:12 B200-hour 实验 | 未执行 | 缺少 Stanford API 权限 | 没有真实小规模训练观测 |
| Part 3:48 B200-hour 最终配置和 loss | 未得到 | 缺少真实实验与吞吐数据 | fixture 输出不能充当最终答案 |
API /final_submission | 未调用 | 无凭据,也不应误提交 | CLI 默认不会提交,必须显式传入 --submit |
因此,本文是一份完整解释 Part 2、详细解释 Part 3 工程实现、诚实标明 Part 3 实验缺口的学习记录。正式学生提交仍然需要自己的实验、拟合诊断、最终配置、预测 loss 和 write-up。
课程 handout 对正式作业中的 AI 使用有明确限制:可以寻求高层概念帮助和低层文档查询,但不允许让 AI 直接完成作业实现。这里的公开项目是非学生的独立学习记录,不能拿去冒充课程提交。
快速入口
- 独立公共代码仓库
- 官方 Assignment 3 handout
- 完整中文实现指南
- Scaling-law 分析模块
- IsoFLOPs 端到端脚本
- 离线/API 最终配置估计脚本
- 核心测试
- 拟合结果 JSON
一分钟看懂整条链路
Assignment 3 研究的是一个预算分配问题:
在固定训练计算量下,参数量和训练 token 应该如何分配,才能让最终 validation loss 最低?
最小数学模型只有四个量:
| 符号 | 含义 | 本文单位 |
|---|---|---|
| 训练计算量 | FLOPs | |
| 非 embedding 参数量 | parameters | |
| 训练数据量 | tokens | |
| 最终 validation loss | 标量 |
计算量采用 dense Transformer 的常用近似:
整条实现链路是:
多组小规模训练结果
  -> 按相同或相近 compute 分组
  -> 每组选择 final validation loss 最低的 run
  -> 得到 N_opt(C)、D_opt(C)、L_opt(C)
  -> 在 log-log 空间拟合幂律
  -> 外推目标 compute
  -> 把连续预测映射为合法 Transformer 配置
  -> 本地审阅
  -> 只有显式 --submit 才可能提交
Part 2 的最终拟合是:
对应预测:
| 目标 compute | 最优参数量预测 | 最优 token 预测 | validation loss 预测 |
|---|---|---|---|
| FLOPs | 70.054B | 237.911B | 3.28249 |
| FLOPs | 206.119B | 808.596B | 3.09082 |
这些是合成数据上的数学外推,不是 B200 墙钟时间实验结果。
1. 作业到底要求什么
Assignment 3 可以分成三个逻辑阶段。
1.1 用合成数据复现 IsoFLOPs
handout 给出若干固定 compute budget。每个 budget 下有不同模型规模的训练结果。需要:
- 找到每个 compute budget 下 final loss 最低的模型;
- 画出最优参数量随 compute 的变化;
- 画出最优 token 数随 compute 的变化;
- 拟合 scaling law;
- 回答 和 FLOPs 时的预测。
这部分不需要训练模型,重点是理解 IsoFLOPs 方法和拟合过程。
1.2 用最多 12 B200-hour 设计小实验
真实实验阶段不是随便跑一组配置。需要主动设计:
- 选择几个 compute bucket;
- 每个 bucket 选择哪些模型规模;
- 如何分配 token 数;
- 如何控制 learning rate、batch size、precision 等干扰变量;
- 如何用有限预算覆盖最有信息量的区域;
- 如何判断某个 bucket 的最优点是否真的被候选模型“夹住”。
这里的预算是 B200 墙钟时间,不是直接给定的理论 FLOPs。
1.3 外推 48 B200-hour 最终训练
最后需要根据小实验:
- 估计 48 B200-hour 对应的有效训练 FLOPs;
- 预测最优非 embedding 参数量;
- 预测训练 token 数;
- 构造合法
TrainingConfig; - 预测最终 validation loss;
- 解释小实验和拟合结果是否吻合;
- 通过 API 提交最终预测。
正式 write-up 不能只贴一个 JSON。它还要回答:为什么这样选实验、拟合是否可信、哪里是观测、哪里是外推。
2. 先区分 FLOPs 和 B200-hour
这是原文最需要补清楚的地方。
2.1 6ND 是算法计算量
描述的是一次 dense Transformer 训练大约做了多少浮点运算。系数 6 粗略涵盖 forward 和 backward 的主要矩阵运算。
它没有包含:
- GPU 理论峰值是否能跑满;
- kernel 是否高效;
- 内存带宽是否成为瓶颈;
- 通信、checkpoint、evaluation 和数据加载开销;
- 不同模型形状造成的利用率变化;
- BF16、FP8 等精度差异。
因此不能把“B200 理论峰值 × 48 小时”直接当成可靠训练 compute。
2.2 B200-hour 是墙钟资源
1 B200-hour 表示占用一张 B200 一小时。真实可完成的算法 FLOPs 依赖训练栈的有效吞吐。
代码采用的换算方式是从已经完成的 run 校准:
其中 是 API 返回的 used_runtime_seconds, 是这条 run 的有效 FLOPs/s。再取所有有效 的中位数:
48 B200-hour 的目标 compute 才写成:
使用中位数而不是均值,是为了降低异常慢 run 对换算的影响。但它仍然隐含一个重要假设:用于校准的 run 与最终模型在 precision、kernel、并行方式和利用率上具有可比性。
2.3 9.6e18 不是 48 B200-hour
仓库 fixture 示例使用:
9.6e18 FLOPs这个值只是离线端到端测试的显式目标,用来证明 pipeline 可以生成结果。它没有来自真实 B200 吞吐校准,也不能解释成 48 B200-hour。
当数据里没有 used_runtime_seconds 时,CLI 要求显式传入 --target-flops。这是一种离线分析入口,不是时间换算的替代证明。
3. Part 2 数据长什么样
data/isoflops_curves.json 包含 72 条合成 run:
- 9 个 compute budget;
- 每个 budget 8 个模型规模;
- compute 范围是 到 FLOPs;
- 每条记录包含
parameters、compute_budget和final_loss。
概念上,一条记录可以写成:
{
  "parameters": 761748216,
  "compute_budget": 6e18,
  "final_loss": 5.8999
}
Part 2 的 parameters 是数据文件直接提供的字段。不要把它与 Part 3 根据架构近似重建的参数量混为一谈。Part 3 才使用:
4. IsoFLOPs 为什么要“固定 compute”
如果直接比较两个训练 run,模型 A 可能更大、token 更多、compute 也更多。即使 A 的 loss 更低,也无法判断改进来自模型规模还是额外预算。
IsoFLOPs 的做法是固定 。在同一个 profile 中:
所以增大 必然减少 ;减小 则允许训练更多 token。profile 中的最低 loss 点就是这个 compute budget 下的最佳参数/数据分配。
直观上,loss 随模型规模常呈现类似 U 形趋势:
模型太小                         模型太大
容量不足                          token 不足
     \                            /
      \____ 当前 compute 的最优点 _/
handout 的简化方案不要求为每个 profile 再拟合一条二次曲线,只需在候选 run 中选择 final loss 最低者。代码也采用这个定义。
5. 从一条 run 推出 token 数
dataset_tokens_for_compute 实现:
以第一个最优点为例:
则:
也就是约 13.12 亿 token。
代码会拒绝非正的 compute 或参数量。这个检查很重要,因为幂律拟合和对数变换都要求输入为正。
6. 如何选择 9 个最优点
Part 2 的 select_isoflops_optima 做三件事:
- 按
compute_budget的精确值分组; - 每组用
min(final_loss)选择最佳 run; - 根据最佳 run 的参数量推导 token 数。
伪代码如下:
for compute_budget, runs in group_by_exact_compute(all_runs):
    best = min(runs, key=lambda run: run.final_loss)
    tokens = compute_budget / (6 * best.parameters)
    optima.append((compute_budget, best.parameters, tokens, best.final_loss))
合成数据的 9 个最优点是:
| Compute FLOPs | 最优参数量 | 推导 tokens | Final loss |
|---|---|---|---|
| 0.762B | 1.312B | 5.8999 | |
| 0.807B | 2.066B | 5.6179 | |
| 1.537B | 3.253B | 5.1072 | |
| 1.952B | 5.123B | 4.8306 | |
| 3.253B | 5.123B | 4.6529 | |
| 5.904B | 8.469B | 4.3112 | |
| 6.971B | 14.345B | 4.1212 | |
| 6.859B | 24.298B | 4.0028 | |
| 12.149B | 41.156B | 3.7732 |
注意第八个最优参数量略小于第七个。这说明有限候选、合成噪声和离散网格会让观测最优点不完全单调。拟合不是简单连接这些点,而是在 log 空间估计整体趋势。
7. 为什么幂律要在 log-log 空间拟合
假设最优参数量满足:
两边取自然对数:
定义:
问题就变成普通一元线性回归:
fit_power_law 没有调用黑盒优化器,而是直接计算:
实现还返回:
rmse_log:log 空间残差的均方根;r_squared_log:log 空间 ;n_points:参与拟合的点数。
至少需要两个正数点,且所有 不能完全相同。整体 IsoFLOPs 分析为了同时拟合 loss law,进一步要求至少三个最优点。
8. 参数 law 与 token law 不是两份独立证据
代码分别拟合:
但每个 token 最优点都由 推导,因此两条曲线存在代数约束:
所以理论上:
当前结果恰好满足:
这不是巧合,也不意味着数据和参数两条曲线提供了两次独立验证。token law 很大程度上是参数 law 与 假设的代数结果。
9. Part 2 拟合结果
模型规模拟合:
数据规模拟合:
诊断指标:
| 拟合 | log-RMSE | log- | 点数 |
|---|---|---|---|
| 0.13802 | 0.97870 | 9 | |
| 0.13802 | 0.98335 | 9 |
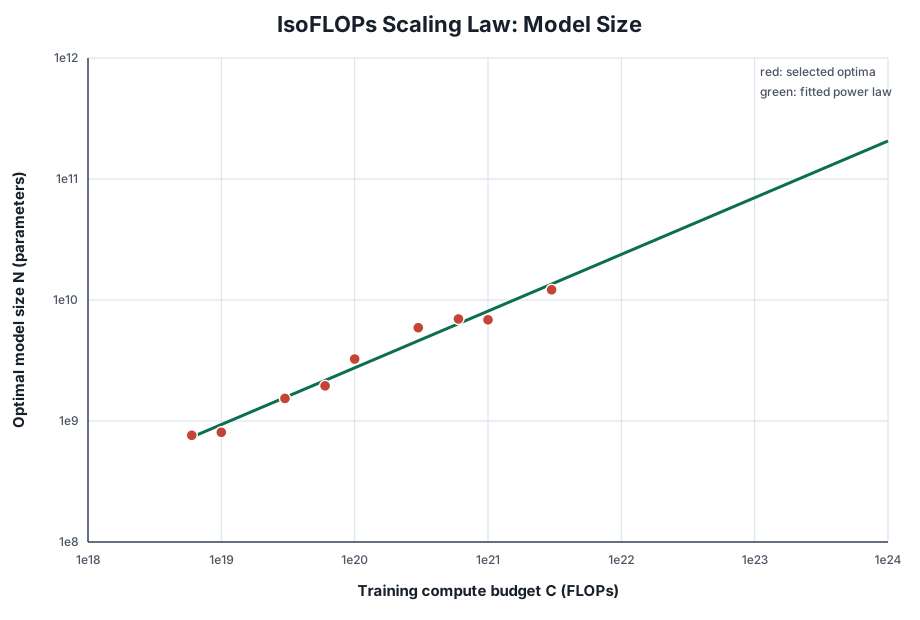
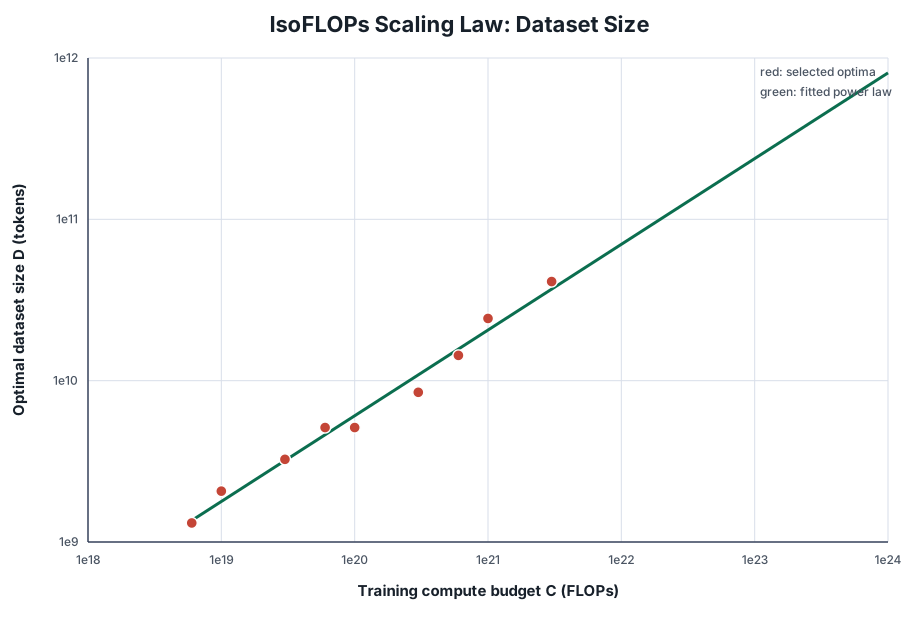
将目标 compute 代入幂律:
| 目标 compute | 参数量预测 | token 预测 |
|---|---|---|
| 70,054,233,905 | 237,910,911,842 | |
| 206,118,539,185 | 808,596,195,789 |
换成更容易阅读的单位:
- FLOPs:约 700.5 亿参数、2379 亿 token;
- FLOPs:约 2061 亿参数、8086 亿 token。
这里还修正了一个 PDF 文本抽取问题:上标 有时会被 OCR 成普通整数 1024。脚本、测试和 JSON 使用的都是正确的 FLOPs。
10. validation loss 如何拟合
最终提交不仅要给 和 ,还要预测 validation loss。仓库采用:
其中:
- 是假设的不可约损失;
- 是尺度系数;
- 通常应为负,表示 compute 增加时 loss 降低。
由于 未知,代码不能直接对 取对数。实现采用透明的网格搜索:
- 在低于最小观测 loss 的范围内取 1000 个候选 ;
- 对每个 计算 ;
- 拟合 与 ;
- 回到原始 loss 空间计算 RMSE;
- 选择原始 loss RMSE 最小的候选。
合成数据拟合得到:
| 指标 | 数值 |
|---|---|
| 不可约损失 | 2.70808 |
| 指数 | -0.17631 |
| 原始 loss RMSE | 0.00268 |
| 原始 loss | 0.999985 |
因此:
- ;
- 。
这个 loss law 是仓库选择的 heuristic,不是 handout 强制指定的方法。实现也没有硬性约束 ,因此对真实实验使用时必须检查指数符号、残差和单调性,不能只看代码有没有成功返回。
11. 为什么高拟合优度仍然不等于可靠
最大的观测 compute 是:
而两个目标分别是:
也就是说,第二个答案把拟合曲线外推到了观测上限的约 333 倍。观测区间内接近 1 的 只能说明这 9 个点贴合当前函数,并不能证明跨越数百倍 compute 后函数形式仍然不变。
可能导致失效的因素包括:
- 模型架构在更大规模发生变化;
- learning rate、batch size 没有随规模正确调整;
- 高质量 token 不足,重复数据和低质量数据占比上升;
- BF16、FP8、MoE 等改变每 token 实际成本;
- 小模型和大模型的 MFU 不同;
- validation loss 与 reasoning、coding 等能力不共享同一个 compute optimum。
更严谨的分析应补充:
- leave-one-budget-out:每次去掉一个 compute bucket 后重新拟合;
- bootstrap:对最优点重采样,给预测区间;
- profile holdout:预留最高 compute bucket,不参与拟合;
- 残差图:检查低 compute 和高 compute 是否有系统性偏差;
- 敏感性分析:改变分组容差、loss law 和候选 范围。
当前仓库没有实现这些不确定性估计,因此本文只报告点预测,不伪造置信区间。
12. Part 2 代码如何串起来
端到端入口是 scripts/chinchilla_isoflops.py:
uv run python scripts/chinchilla_isoflops.py \
  --output-dir docs/figures
执行顺序:
load_isoflops_runs
  -> select_isoflops_optima
  -> fit_isoflops_scaling_law
       -> fit_power_law(N)
       -> fit_power_law(D)
       -> fit_loss_power_law(L)
  -> predict_parameters / predict_dataset_tokens / predict_loss
  -> 写 SVG
  -> 写 isoflops_summary.json
主要文件映射:
| 文件或函数 | 责任 |
|---|---|
analysis/isoflops.py::IsoFLOPsRun | 保存 ,按需计算 |
dataset_tokens_for_compute | 实现 |
load_isoflops_runs | 从 JSON 读取合成 run |
select_isoflops_optima | 按精确 compute 分组并取最低 loss |
fit_isoflops_scaling_law | 组织参数、token、loss 三类拟合 |
analysis/power_law.py::fit_power_law | log-log OLS |
fit_loss_power_law | 扫描 并拟合 loss law |
scripts/chinchilla_isoflops.py | CLI、图表和 JSON 输出 |
合成数据按 compute 的精确浮点值分组。这适用于 handout 数据,因为同一 profile 的 compute_budget 本来就完全一致;真实 API run 受 token 量化影响,不能沿用精确分组。
13. Part 3 应该怎样设计实验
下面是一个实验设计框架,不是已经执行的 Stanford 实验记录。
13.1 先固定控制变量
如果每条 run 同时改变模型大小、token、learning rate、batch、precision 和数据顺序,最后无法判断 loss 差异来自什么。第一轮应该尽量固定:
- tokenizer 和训练数据分布;
- sequence length;
- precision;
- optimizer family、betas、weight decay;
- warmup/cosine schedule 形式;
- evaluation 数据和 cadence;
- 随机种子策略。
模型大小和 token 数是主变量。learning rate 可以先使用一条明确的规模 heuristic,但必须承认它是潜在混杂因素。
13.2 设置多个 compute bucket
至少需要三个最终 compute group 才能拟合仓库中的 scaling law。实际实验最好使用四个或更多 bucket:
低 compute        中低 compute        中高 compute        高 compute
    |                  |                   |                  |
多个模型规模       多个模型规模        多个模型规模       多个模型规模
bucket 应大致按对数间隔,而不是线性间隔。幂律关系在 log 空间建模,对数间隔能更均匀地覆盖尺度。
13.3 每个 bucket 要夹住最优点
每个 compute bucket 不应只跑一个模型。至少要在预期最优规模周围放置:
- 一个明显偏小、token 较多的模型;
- 一个中间模型;
- 一个偏大、token 较少的模型。
如果最低 loss 出现在候选范围最左或最右,说明最优点没有被夹住。下一轮应该向该方向扩展,而不是立刻拿边界点拟合。
13.4 分阶段花掉 12 B200-hour
一个更稳妥的预算策略是:
| 阶段 | 建议预算比例 | 目的 |
|---|---|---|
| 极短 pilot | 10%–15% | 验证配置合法、吞吐和 loss 曲线正常 |
| 主 IsoFLOPs 网格 | 60%–70% | 覆盖多个 compute bucket 与模型规模 |
| 边界补点/复验 | 15%–20% | 修正没有夹住最优点的 bucket |
| 安全余量 | 5%–10% | 处理失败、超时和队列占用 |
这里使用比例而不是伪造具体 run 数,因为一条 run 的成本取决于模型形状和实际吞吐。应先用 pilot 获得 used_runtime_seconds,再规划后续配置。
13.5 理解 API 预算预留
handout 的 API 预算语义会直接影响实验调度:
- queued/running run 会按
max_runtime_seconds预留预算; - completed 或 failed 后,才按实际运行时间结算;
- 同时排队多个长
max_runtime_seconds任务,可能暂时占满可用预算。
因此不应一次性提交大量 12 小时上限的任务。先用较短 pilot 校准运行时间,再逐步扩展更安全。
14. Part 3 如何清洗 API 数据
completed_runs_from_api_payload 只接受:
status.status_type == "completed"并读取:
status.val_losses[-1]以下记录会被跳过:
- queued;
- running;
- failed;
- timeout;
- completed 但
val_losses为空。
原因是 failed run 的 partial loss 不代表完整训练终点。如果把它与 completed run 混在一起,训练更久的配置和提前失败的配置就不可比。
需要注意:
- “completed-only”过滤只适用于 API payload;
completed-runs离线格式没有状态字段,代码默认每条记录已经由使用者清洗;--input-format auto只检查 JSON 第一条记录,混合格式不是受支持输入。
15. Part 3 如何从配置重建参数与 compute
API 返回的是 TrainingConfig,不一定直接给出统一的非 embedding 参数字段。代码使用 handout 近似:
其中:
- 是 Transformer 层数;
- 是 hidden size。
再用配置中的 total_train_tokens 计算:
这是为了让不同架构映射到统一的 scaling 坐标。它不是模型真实参数精确计数:词表 embedding、输出层、norm、bias、GQA/MQA 细节等不会完全由这个公式表示。
Part 2 和 Part 3 的参数来源必须分开理解:
| 场景 | 参数量来源 |
|---|---|
| Part 2 合成数据 | JSON 直接提供 parameters |
| Part 3 API run | 由 近似重建 |
16. 为什么真实 run 使用 2% 近似分组
配置的 token 数需要满足 batch、sequence length 和 evaluation cadence 的整除约束。即使设计时希望几条 run 使用完全相同 compute,量化后也可能出现轻微差异。
select_compute_group_optima 因此:
- 按
compute_flops排序; - 计算当前最后一组的 compute 几何均值;
- 若新 run 与组中心相对差不超过 2%,加入该组;
- 否则创建新组;
- 每组选择 final loss 最低的 run。
相对差定义为:
组中心使用几何均值:
这里有两个实现细节:
- 这是排序后的贪心分组,不是全局聚类;
- 最优点的参数和 loss 来自组内最佳 run,但 compute 使用整组几何中心,token 又根据该中心重新计算。
所以生成的 optimum 可能不再逐字段对应某一条原始 run。这样做有利于构造稳定 profile 中心,但 write-up 应把这个定义写清楚。
17. 从 completed runs 到 48 小时预测
fit_scaling_from_completed_runs 的完整顺序是:
completed runs
  -> 若未显式给 target FLOPs:
       估计有效 FLOPs/s 中位数
       target_flops = 48 * 3600 * median_rate
  -> 用 2% 容差建立 compute groups
  -> 每组选择最低 final loss
  -> 拟合 N_opt(C)、D_opt(C)、L(C)
  -> 在 target_flops 处预测连续 N、D、L
  -> 把 N、D 映射成合法 TrainingConfig
若没有任何正的 used_runtime_seconds,并且也没有显式给 --target-flops,代码会报错。它不会悄悄拿 B200 理论峰值猜测。
吞吐校准也需要审查:
- 是否混入短到被启动开销主导的 run;
- 是否混入失败或限速 run;
- 不同模型规模的 FLOPs/s 是否系统性变化;
- 最终模型是否远大于用于估计吞吐的模型;
- 是否应该只使用形状接近最终候选的 runs。
当前实现采用所有有效 completed runs 的中位数,是一个简单基线,不是完整硬件性能模型。
18. 连续预测如何变成合法架构
Scaling law 输出的参数量是连续值,例如:
557,710,000.4 parameters真实 Transformer 需要整数层数、hidden size 和 attention heads。配置模块在以下搜索空间中寻找最接近目标参数量的候选:
num_hidden_layers:4 到 80;head_dim:64 或 128;hidden_size:对齐到 64 与 head dimension 的公倍数;num_attention_heads = hidden_size / head_dim。
候选参数量仍按:
排序优先级是:
- 参数相对误差最小;
- attention head 数更接近 32;
- 层数更少。
FFN intermediate size 使用近似 SwiGLU 比例:
并向上对齐到 256 的倍数。
这个搜索只解决“生成一个合法且参数量接近的架构”。它没有证明 depth-width 比例是 loss 最优,也没有联合拟合 GQA、RoPE 或 FFN expansion。
19. token 数为什么还要量化
默认配置使用:
- sequence length:512;
- train batch size:128;
- evaluation 次数:16。
为了让总 optimizer steps 能被 evaluation cadence 整除,token 数按下面的单位量化:
实现将预测 token 四舍五入到这个单位的整数倍,并限制不超过:
即 5000 亿 token。
这会产生两个差异:
- 量化后 token 数不等于连续幂律预测;
- 超过 5000 亿的预测会被截断。
因此最终配置的实际:
通常不完全等于原目标 。当前 predicted_loss 仍然是在连续目标 compute 上计算,代码不会根据离散配置的实际 compute 重新拟合或重算 loss。这是结果审阅时必须记录的误差来源。
20. optimizer 配置来自哪里
若调用方没有指定 peak_lr,代码使用:
再截断到:
其余默认值包括:
| 项目 | 值 |
|---|---|
| optimizer | AdamW |
| beta1 | 0.9 |
| beta2 | 0.95 |
| weight decay | 0.01 |
| gradient clip norm | 1.0 |
| warmup fraction | 0.05 |
| final LR fraction | 0.1 |
这些值构成一个可运行的 conservative baseline,但不是由 Part 3 实验联合拟合出来的最优超参数。正式实验应该至少检查 learning rate 是否在不同模型规模下合理。
21. 离线 fixture 到底证明了什么
仓库提供 completed_scaling_runs.json,用于测试 completed-run 数据链路。示例命令:
uv run python scripts/estimate_final_config.py \
  --input tests/fixtures/completed_scaling_runs.json \
  --input-format completed-runs \
  --target-flops 9.6e18 \
  --output-json /tmp/final_estimate.json
示例输出:
| 项目 | 数值 |
|---|---|
| 显式目标 compute | FLOPs |
| 连续参数预测 | 557.710M |
| 连续 token 预测 | 2.869B |
| 量化后 token | 2,868,903,936 |
| 连续 loss 预测 | 3.20724 |
| 离散架构 | 35 layers / 1152 hidden / 18 heads |
它能证明:
- JSON 可以读取;
- 至少三个 compute group 时拟合可以完成;
- 连续预测可以生成合法
TrainingConfig; - 输出可以 JSON 序列化;
- 默认路径不会调用远端提交。
它不能证明:
- 等于 48 B200-hour;
- fixture loss 来自 Stanford 训练;
- 生成架构能在 48 小时内完成;
- prediction 在 leaderboard 上准确;
- learning rate heuristic 是最优的。
22. API 模式与安全提交边界
有真实权限时,可以先只拉取和分析:
export A3_API_KEY="<student-id>"

uv run python scripts/estimate_final_config.py \
  --fetch-api \
  --export-api-experiments local_experiments.json \
  --target-b200-hours 48 \
  --output-json final_estimate.json
这个命令不含 --submit,因此只会:
- 拉取实验;
- 导出原始 payload;
- 过滤 completed runs;
- 拟合并生成本地 JSON;
- 在 stdout 打印结果。
人工检查至少应包括:
- completed run 数量;
- compute group 是否足够;
- 每组最优点是否位于候选边界;
- 有效 FLOPs/s 是否随模型规模显著变化;
- 参数、token 和 loss 指数是否合理;
- 连续预测与离散配置之间的相对误差;
max_runtime_seconds是否真的是目标墙钟预算。
只有确认无误后,正式学生才可能显式运行:
uv run python scripts/estimate_final_config.py \
  --fetch-api \
  --target-b200-hours 48 \
  --submit
本文没有执行这一步。
还有一个 CLI 细节:--output-json 会在 API submission 之前写文件。如果同时使用 --submit,提交响应只会加入随后打印到 stdout 的 payload,不会回写之前的 JSON 文件。
23. 输入格式与边界条件
最终配置 CLI 支持:
--input-format | 输入内容 |
|---|---|
api | 完整 API experiment payload,包含 status 和 training config |
completed-runs | 已清洗的 CompletedScalingRun 风格记录 |
isoflops | Part 2 风格的 parameters/compute_budget/final_loss |
auto | 根据第一条 JSON 记录猜测格式 |
重要边界条件:
- 总记录少于 3 条会失败;
- 分组后少于 3 个 compute group 也会失败;
- power-law 输入必须为正;
- 所有 compute 完全相同无法拟合斜率;
- API completed run 必须有非空
val_losses; - 时间换算必须至少有一个正的
used_runtime_seconds; - 若显式给
--target-flops,target_seconds不再由 B200-hours 计算; - 显式 target FLOPs 路径生成配置时,runtime 会回退为固定 48 小时。
最后一点尤其容易误读:显式 --target-flops 只说明算法计算目标,并没有证明该配置与 48 B200-hour 一致。
24. 测试覆盖了什么
核心分析测试当前包含 8 个用例,另有 4 个配置/环境测试,共 12 个目标测试。
| 测试 | 防止的错误 |
|---|---|
| 已知幂律恢复 | log-log OLS 斜率和系数计算错误 |
| 每预算最低 loss | 选错 IsoFLOPs optimum |
| assignment data 正值外推 | 指定 compute 下产生非正或逆序预测 |
| token 公式系数错误 | |
| 配置合法性 | 参数偏差过大或整除关系失效 |
| 架构与 token 量化 | head/hidden 不匹配或量化单位错误 |
| completed-only 过滤 | 把 queued run 混入拟合 |
| fixture 端到端 | 读取、分组、拟合、配置和 JSON 链路断裂 |
当前尚未直接覆盖:
- loss 网格搜索能否恢复已知 ;
- 2% 分组边界等于阈值时的行为;
- 贪心分组对边界点顺序的敏感性;
- FLOPs/s 中位数的异常值案例;
- 5000 亿 token 截断;
--input-format auto的错误首条记录;- CLI 输出文件与
--submit响应差异; - 显式 target FLOPs 时 runtime 回退。
因此“12 tests passed”证明的是当前已覆盖路径没有回归,不是整个 Part 3 推断过程已经被充分统计验证。
25. 本地复现步骤
安装:
git clone https://github.com/keepkeen/cs336-assignment3-scaling.git
cd cs336-assignment3-scaling
uv sync --extra server
复现 Part 2:
uv run python scripts/chinchilla_isoflops.py \
  --output-dir docs/figures
运行离线分析测试:
uv run pytest -q \
  tests/test_analysis.py \
  tests/test_config.py
静态检查:
uv run ruff check cs336_scaling scripts tests

uv run ty check \
  cs336_scaling/analysis \
  scripts/chinchilla_isoflops.py \
  scripts/estimate_final_config.py \
  tests/test_analysis.py \
  tests/test_config.py
数据库支持的 API/scheduler 全量测试需要 PostgreSQL 和对应环境变量。它与不依赖数据库的 scaling-law 分析测试是两套验证范围,不能混写成“所有测试均通过”。
26. 文件与任务对应关系
| 作业问题 | 实现文件 |
|---|---|
| Part 2 数据读取 | analysis/isoflops.py |
| IsoFLOPs 最优点 | select_isoflops_optima |
| 参数/token 幂律 | analysis/power_law.py |
| validation loss law | fit_loss_power_law |
| Part 2 图表与 JSON | scripts/chinchilla_isoflops.py |
| API completed-only 过滤 | analysis/experiments.py |
| 近似 compute 分组 | select_compute_group_optima |
| B200-hour 吞吐换算 | estimate_flops_per_second |
| 连续目标外推 | fit_scaling_from_completed_runs |
| 架构搜索 | analysis/configs.py |
| token 量化 | quantize_train_tokens |
| optimizer 与 TrainingConfig | build_training_config_for_target |
| 离线/API CLI | scripts/estimate_final_config.py |
| 合法性 schema | training/training_config.py |
| 核心回归测试 | tests/test_analysis.py |
27. 什么才算真正完成 Part 3
如果未来获得等价训练环境,要把当前工程管线升级为完整作业结果,至少还需要:
- 记录 12 B200-hour 内每条实验的选择理由;
- 保存完整 API payload、运行时间和最终 validation loss;
- 检查每个 compute bucket 的候选是否夹住最优点;
- 报告有效 FLOPs/s 的分布,而不只报中位数;
- 对比不同拟合形式或做 holdout 验证;
- 给出 48 B200-hour 对应的目标 FLOPs;
- 报告连续预测与离散配置的参数/token/compute 偏差;
- 给出完整
TrainingConfig和预测 validation loss; - 解释外推风险与主要假设;
- 最后才通过 API 提交。
缺少第 1–9 项时,单独运行 --submit 只是上传一个未经证明的猜测。
28. 2025–2026:Scaling law 正在扩展什么
这份作业使用的是 dense pretraining 的最小模型:参数、token、compute、loss。近年的工作正在把更多变量纳入同一个预算问题。
直接拟合完整 loss surface
Farseer 不只保留每个 compute profile 的最低点,而是建模完整的 surface。这样能利用未成为 optimum 的 runs,也更适合分析外推误差。
超参数也需要 scaling
Predictable Scale 研究 learning rate、batch size 等超参数如何随模型和数据规模变化。它提醒我们:固定 optimizer recipe 后只外推 ,本身就是一个强假设。
Token 不是同质资源
Scaling Data-Constrained Language Models 说明数据受限、重复训练和数据质量会改变 compute-optimal 分配。增加 token 计数不一定等于增加同等数量的有效信息。
Precision 和 MoE 改变计算模型
Scaling Laws for Precision 将训练与推理精度纳入 scaling。MoE 又会把 total parameters、active parameters 和每 token FLOPs 解耦。此时简单的 不再足够。
最优规模依赖评估目标
Compute Optimal Scaling of Skills 讨论不同能力的 compute-optimal 行为。validation loss 最优只说明对当前验证分布最优,不保证 reasoning、coding 或知识记忆同时最优。
总结
这份作业真正训练的能力不是“把九个点拟合成一条直线”,而是建立一套可审查的决策链:
- 用固定 compute 隔离参数量与 token 数的分配问题;
- 明确定义每个 profile 的最优点;
- 在 log 空间拟合幂律并报告残差;
- 区分算法 FLOPs 与硬件墙钟时间;
- 只用 completed run 构造可比观测;
- 把连续统计预测转换成受约束的离散配置;
- 把观测、heuristic、外推和真实提交分开。
Part 2 的数值、图表和代码已经闭环。Part 3 的离线工程路径也已经实现,但由于没有真实 API experiments,仍然缺少实验设计的实际执行、吞吐校准、48 B200-hour 最终配置和 leaderboard 验证。把这个边界写清楚,比给出一个无法核实的“最终答案”更重要。